Tableau Semantics で高性能なセマンティックモデルを作成するためのベストプラクティス


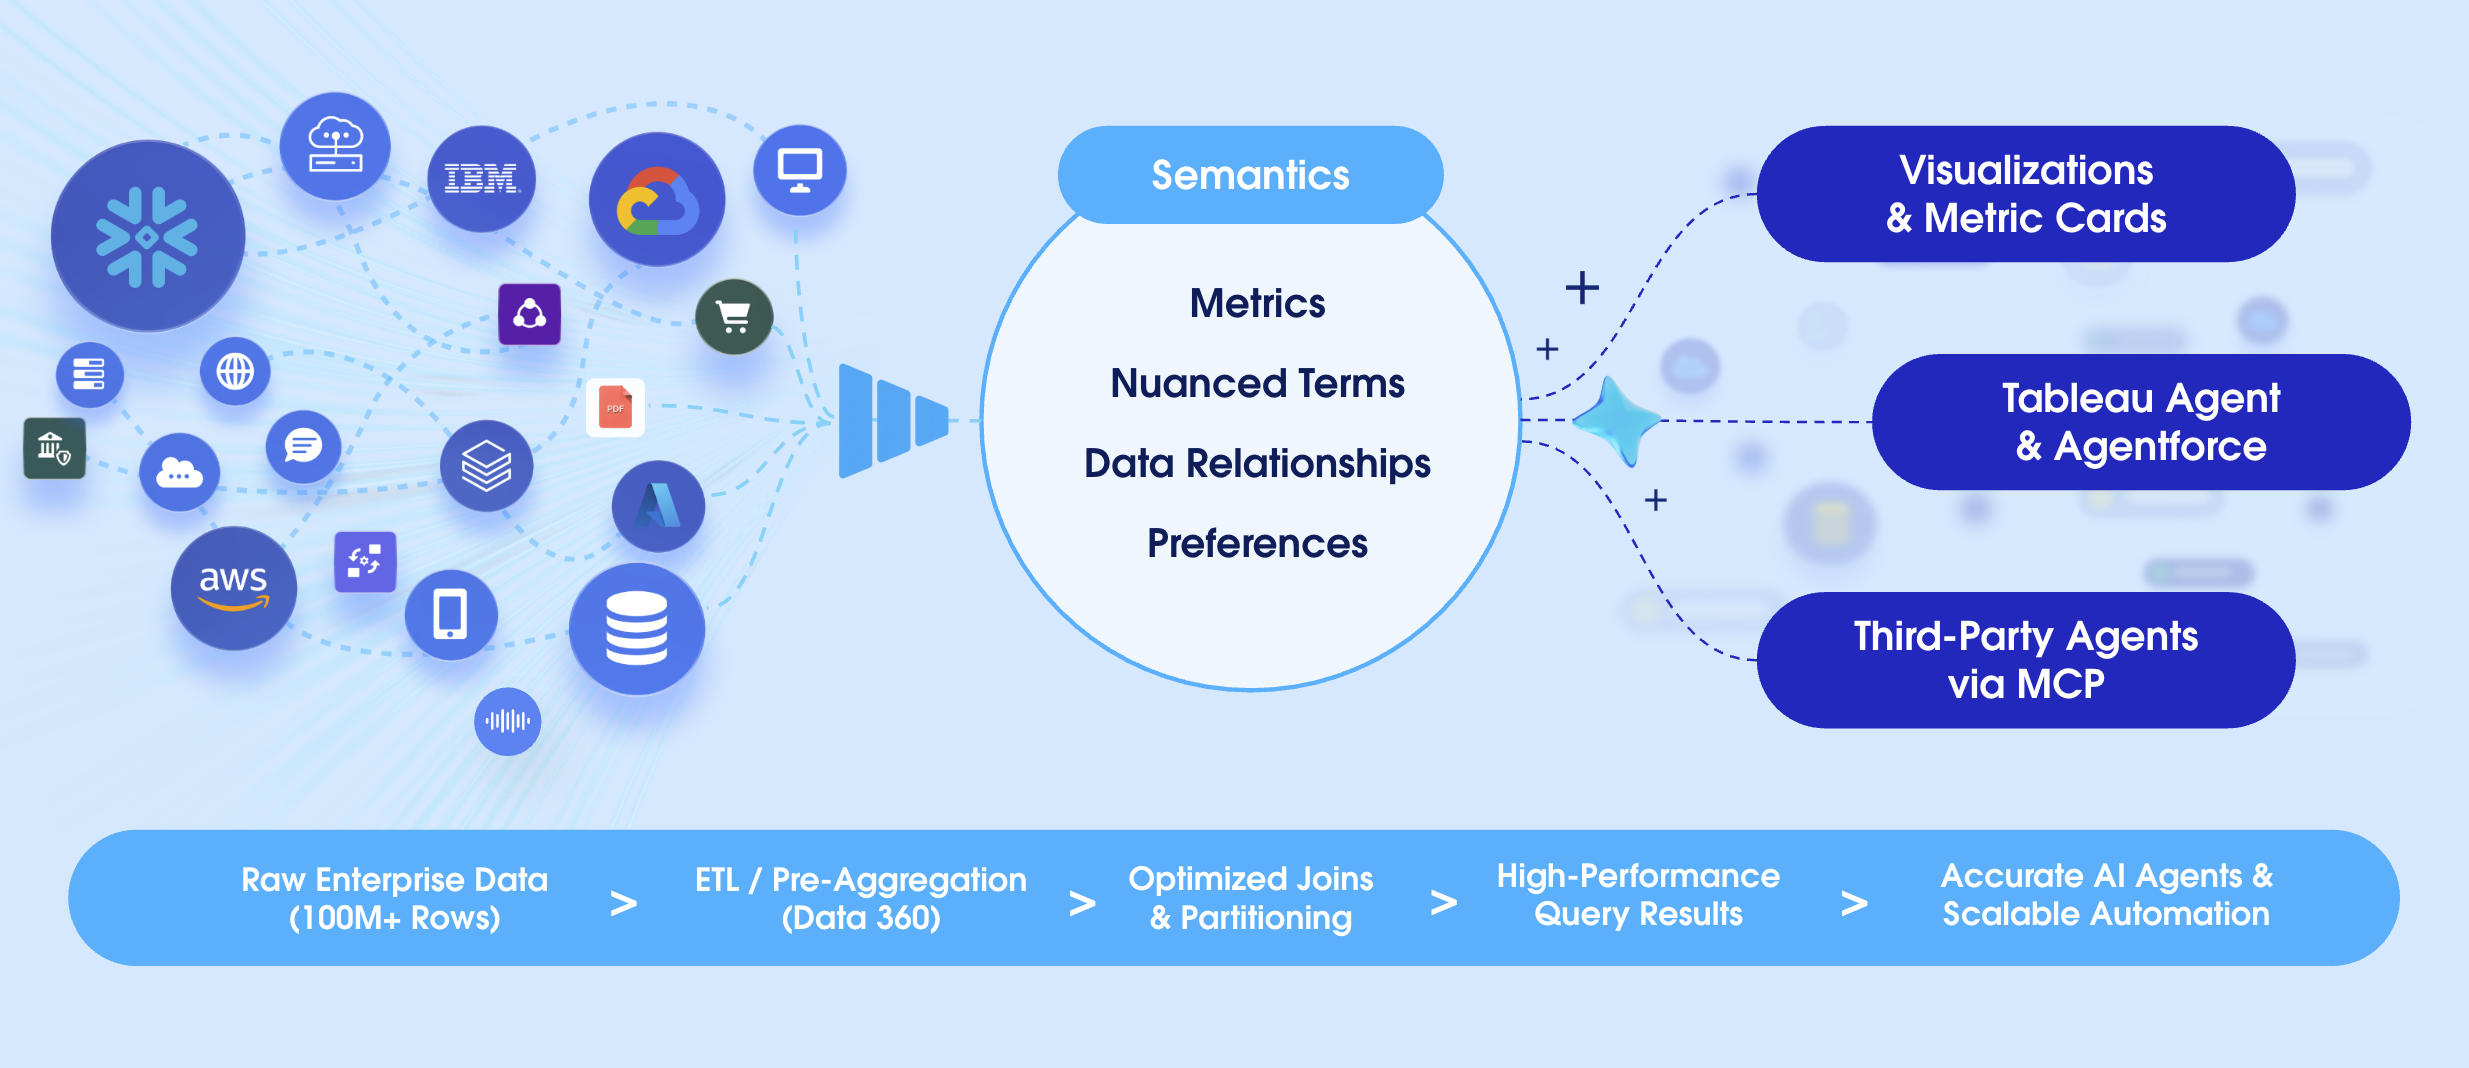
企業のデータアーキテクチャが複雑になるにつれ、生データの保存先とビジネスユーザーとの隔たりを埋めることがますます重要になっています。Tableau Next の Tableau Semanticsは、Data 360 上にネイティブに構築されており、定義済みの指標、データ間の関係、およびビジネス設定に基づいて、生のデータベーススキーマを自社のビジネスで使う言葉に変換します。
どの組織も、収益の定義、戦略的取引先とみなす基準、リスクの測定方法など、ビジネスに関する共通認識を基に運営されています。ガバナンスの行き届いたセマンティックレイヤーがあれば、すべての人、エージェント、アプリケーションが、同じ意味でデータを扱えるようになります。これにより、セルフサービスダッシュボードやアドホックレポートから、Slack、Agentforce、MCP 経由のサードパーティエージェントで AI を活用して得られるインサイトまで、組織全体でデータの定義とビジネスコンテキストが一貫します。
従来の BI システムでは計算処理を個々のレポートに埋め込む必要がありましたが、Tableau Semantics ではビジネスロジックとレポート表示を分離して扱うことができます。「解約率」のような指標を一度定義すれば、重複や論理のずれを起こすことなく、人間の分析と自律型 AI エージェントの両方で安全に利用できるようになります。
Tableau Semantics の中核となるのはセマンティックモデルであり、これは組織における「信頼できる単一の情報源」として機能します。セマンティックモデルの構築は、単にテーブルを接続するだけにとどまりません。その設計はパフォーマンス、ガバナンス、スケーラビリティにとって極めて重要です。
アドバイス: Salesforce のすぐに使えるモデルから始める
必ずしもセマンティックモデルをゼロから構築する必要はありません。Salesforce をご利用の場合、Data 360 には Salesforce Customer 360 セマンティックモデルが含まれています。Salesforce の標準的なビジネスエンティティ (取引先、取引先責任者、商談など) を中心に設計されており、豊富なビジネス設定と事前構築済みの指標を備えています。そのため、すぐに AI で利用でき、カスタマイズも簡単です。
- 統合されたセマンティックレイヤーを Data 360 で構築する方法について、Salesforce 360 ブログでご確認ください。
- Salesforce Customer 360 セマンティックモデルのドキュメントをご覧ください。
以下は、Tableau Semantics でモデリングを行う際に、すべてのデータスチュワード、アーキテクト、データアナリストが従うべき主なベストプラクティスです。
1.ビジネス主導のアプローチを採用する
セマンティックモデルは、バックエンドのデータベース構造ではなく、ビジネスの運営方法を反映するべきです。データベーススキーマに厳密に基づいてモデリングを行うと、過度に複雑な関係性が生じることがよくあり、ビジネスユーザーを混乱させ、クエリの速度が低下します。
- テーブルではなく、質問から始める: ソースオブジェクトを取り込む前に、ステークホルダーが重視する主な指標と、答えを知りたい質問を明確にします。たとえば、 「当社の四半期ごとの解約率は、地域別に見るとどのくらいですか?」
- エンティティを明確に定義する: 顧客、 製品、 注文などのコアエンティティを、技術的なデータベースフィールド名ではなく、標準的なビジネス用語を使用してマッピングします。この点が重要なのは、Agentforce のような自律型エージェントが、人間にも理解しやすい明確な説明を基に回答するためです。モデルで難解なテーブル名を使用している場合、AI エージェントは正確な回答を返すのに苦労します。
2.概念モデルから始める
結合の設定やクエリの実行にすぐに取り掛かりたくなるかもしれませんが、複雑なモデルを本番環境でリファクタリングするほうが、事前に構造を計画するよりもはるかに時間がかかります。
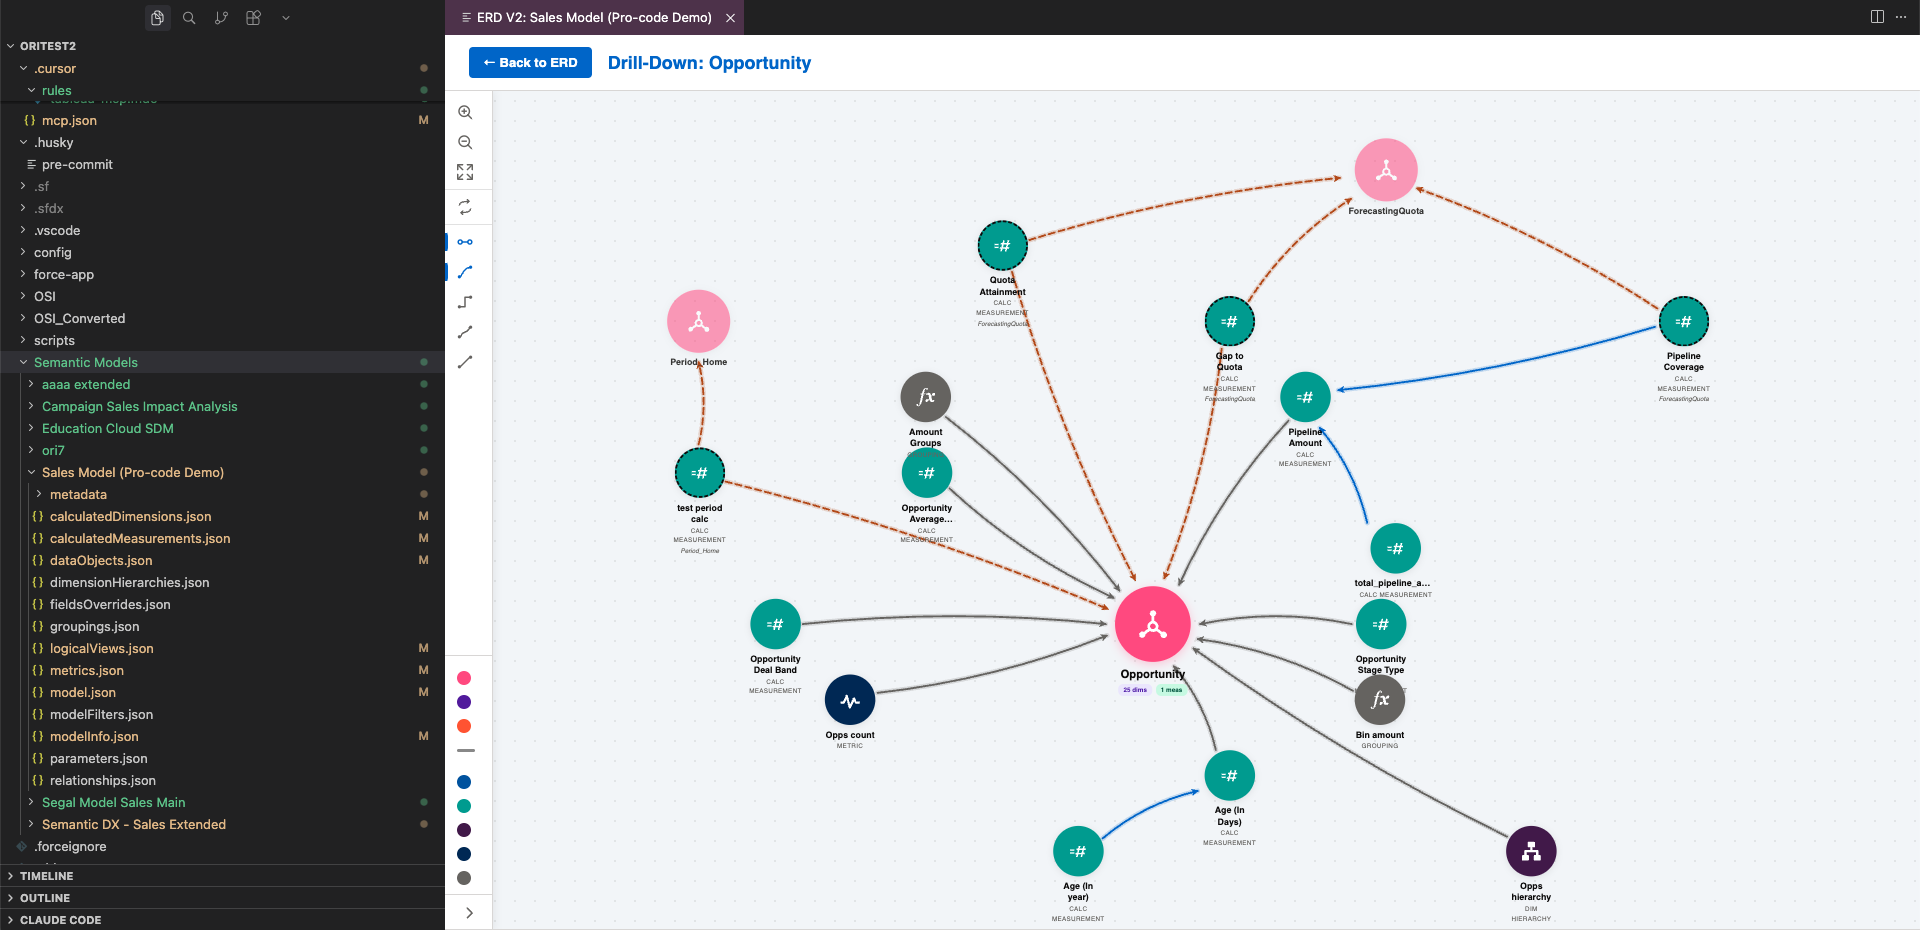
- 構造の全体像を可視化する: 実装の詳細に取りかかる前に、ビジュアルエディターで論理エンティティとその関係を大まかに描きます。
- 論理オブジェクトとデータオブジェクトの違いに注意する: 論理オブジェクトはビジネスコンセプト (例: 「顧客」) を表すのに対し、基となるデータオブジェクト (データレイクオブジェクトまたはデータモデルオブジェクト) は物理的な属性を保持しているということを覚えておきましょう。概念モデリングでは、複数の物理オブジェクトを、整理された 1 つの論理表現にまとめることができます。
- ステークホルダーからのフィードバックを早期に得る: ビジネスオーナーとともに、概念図を用いて関係性を検証します。実装しながら設計するほうが容易な場合が多いものの、概念設計図があれば、単発のレポートだけでなく、長期的なアプリケーションニーズに対応できるモデルを構築できます。
3.モデルの構築方法を選ぶ
Tableau Semantics は、モデル構築のための 3 つの柔軟な方法を提供します。これにより、既存のアーキテクチャと技術的な習熟度に最適なアプローチを選択できます。
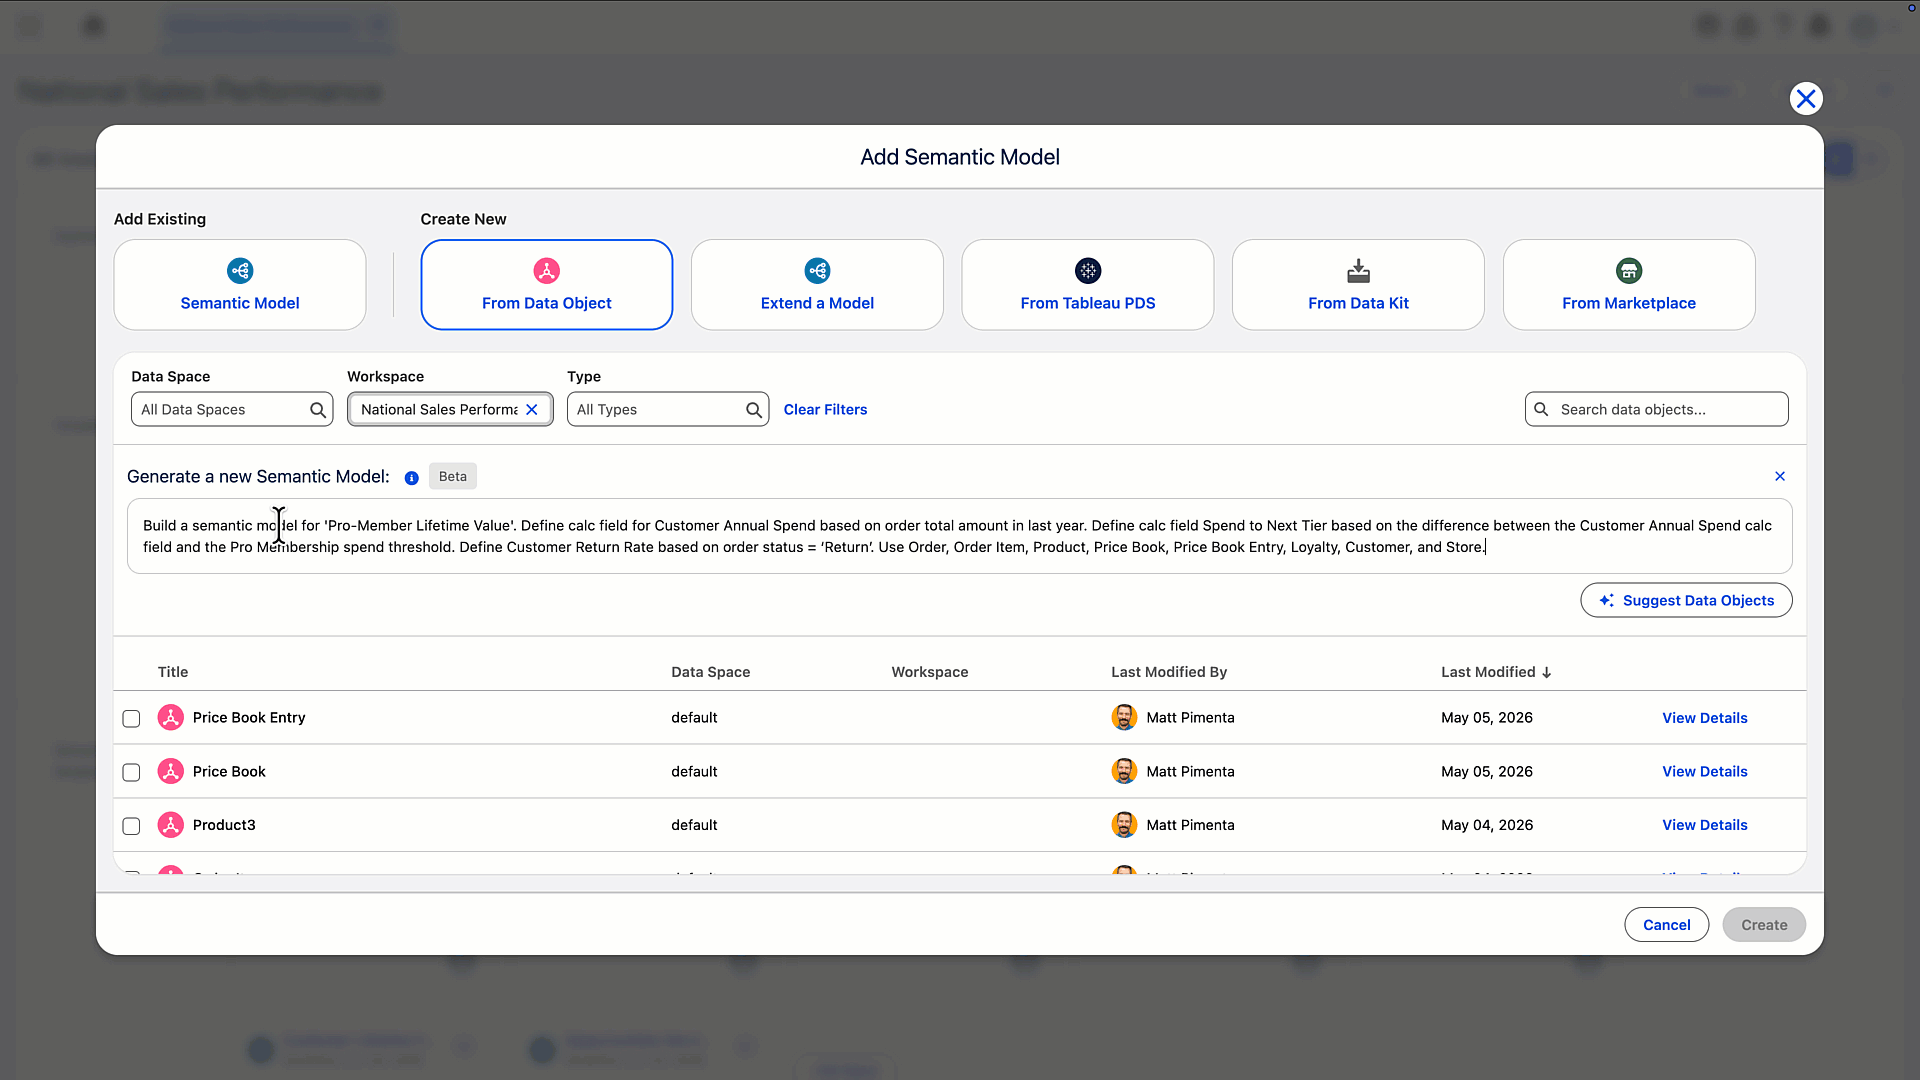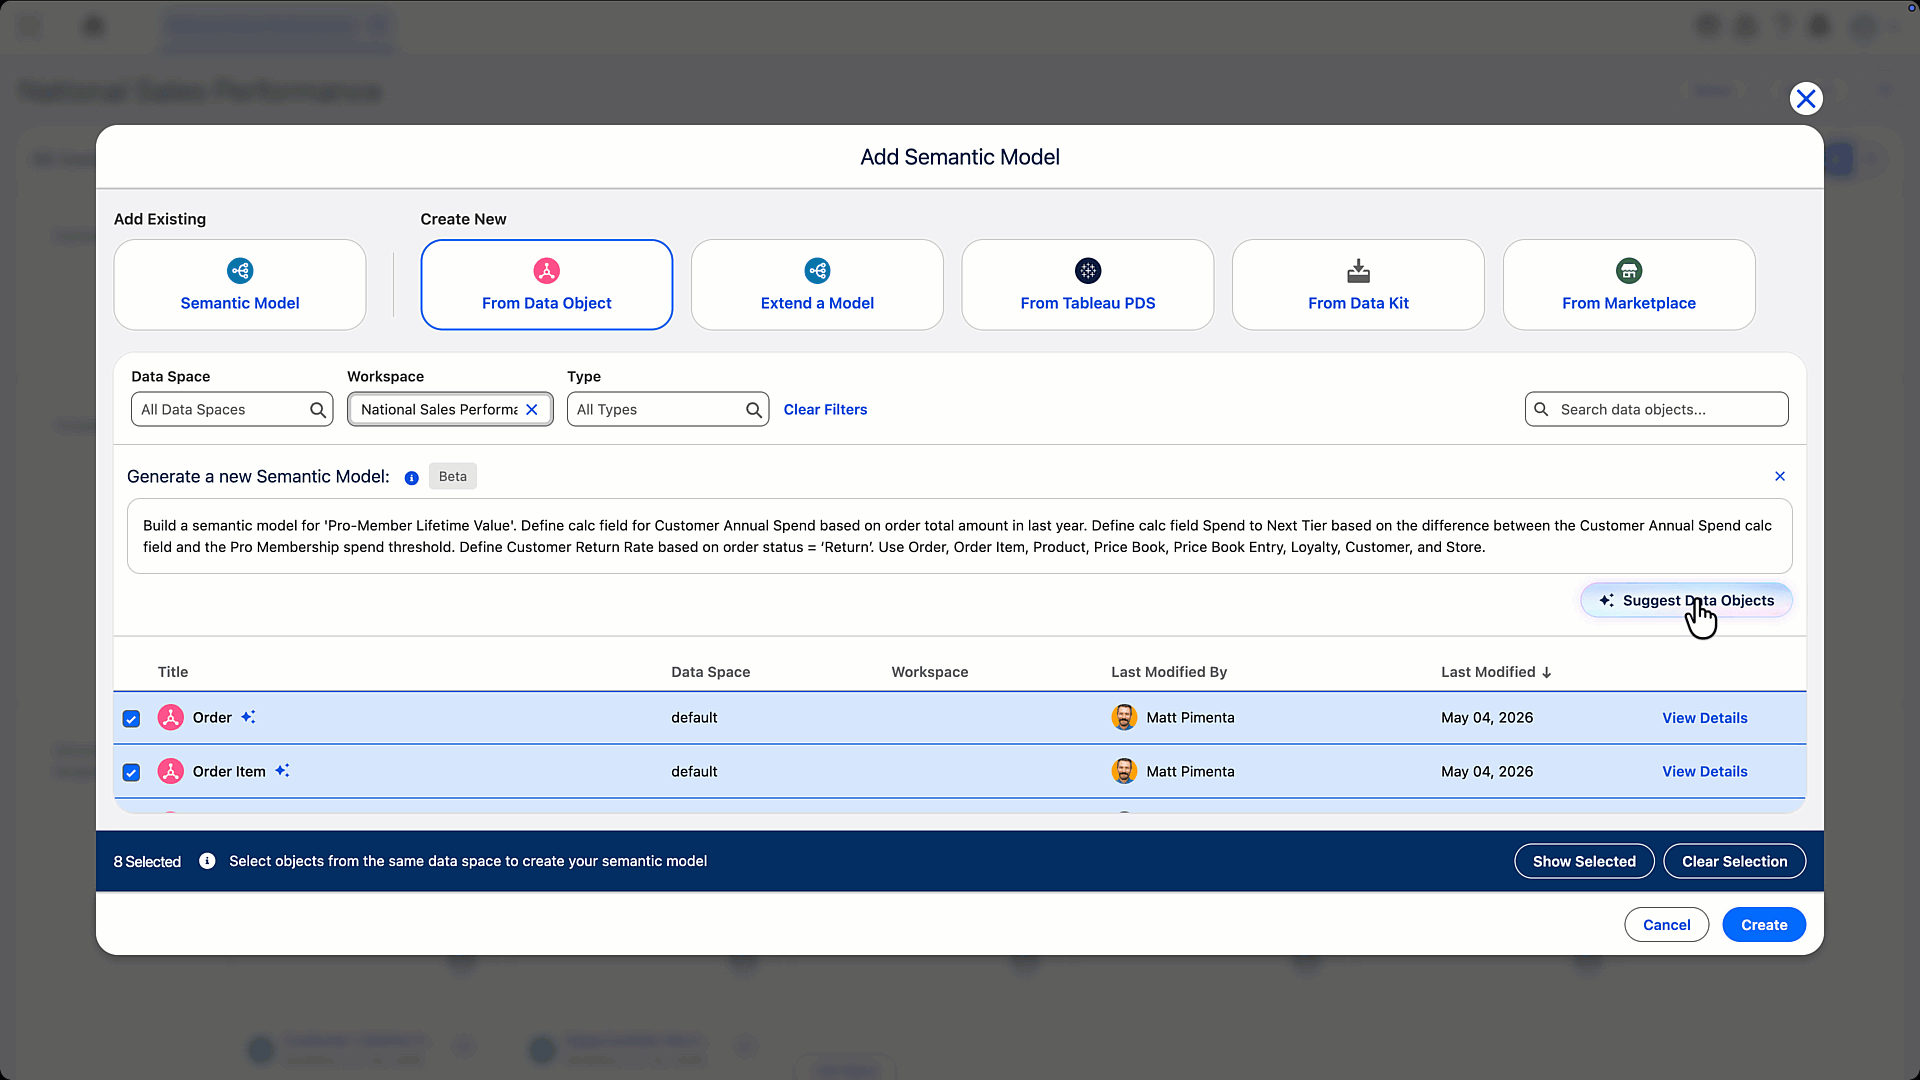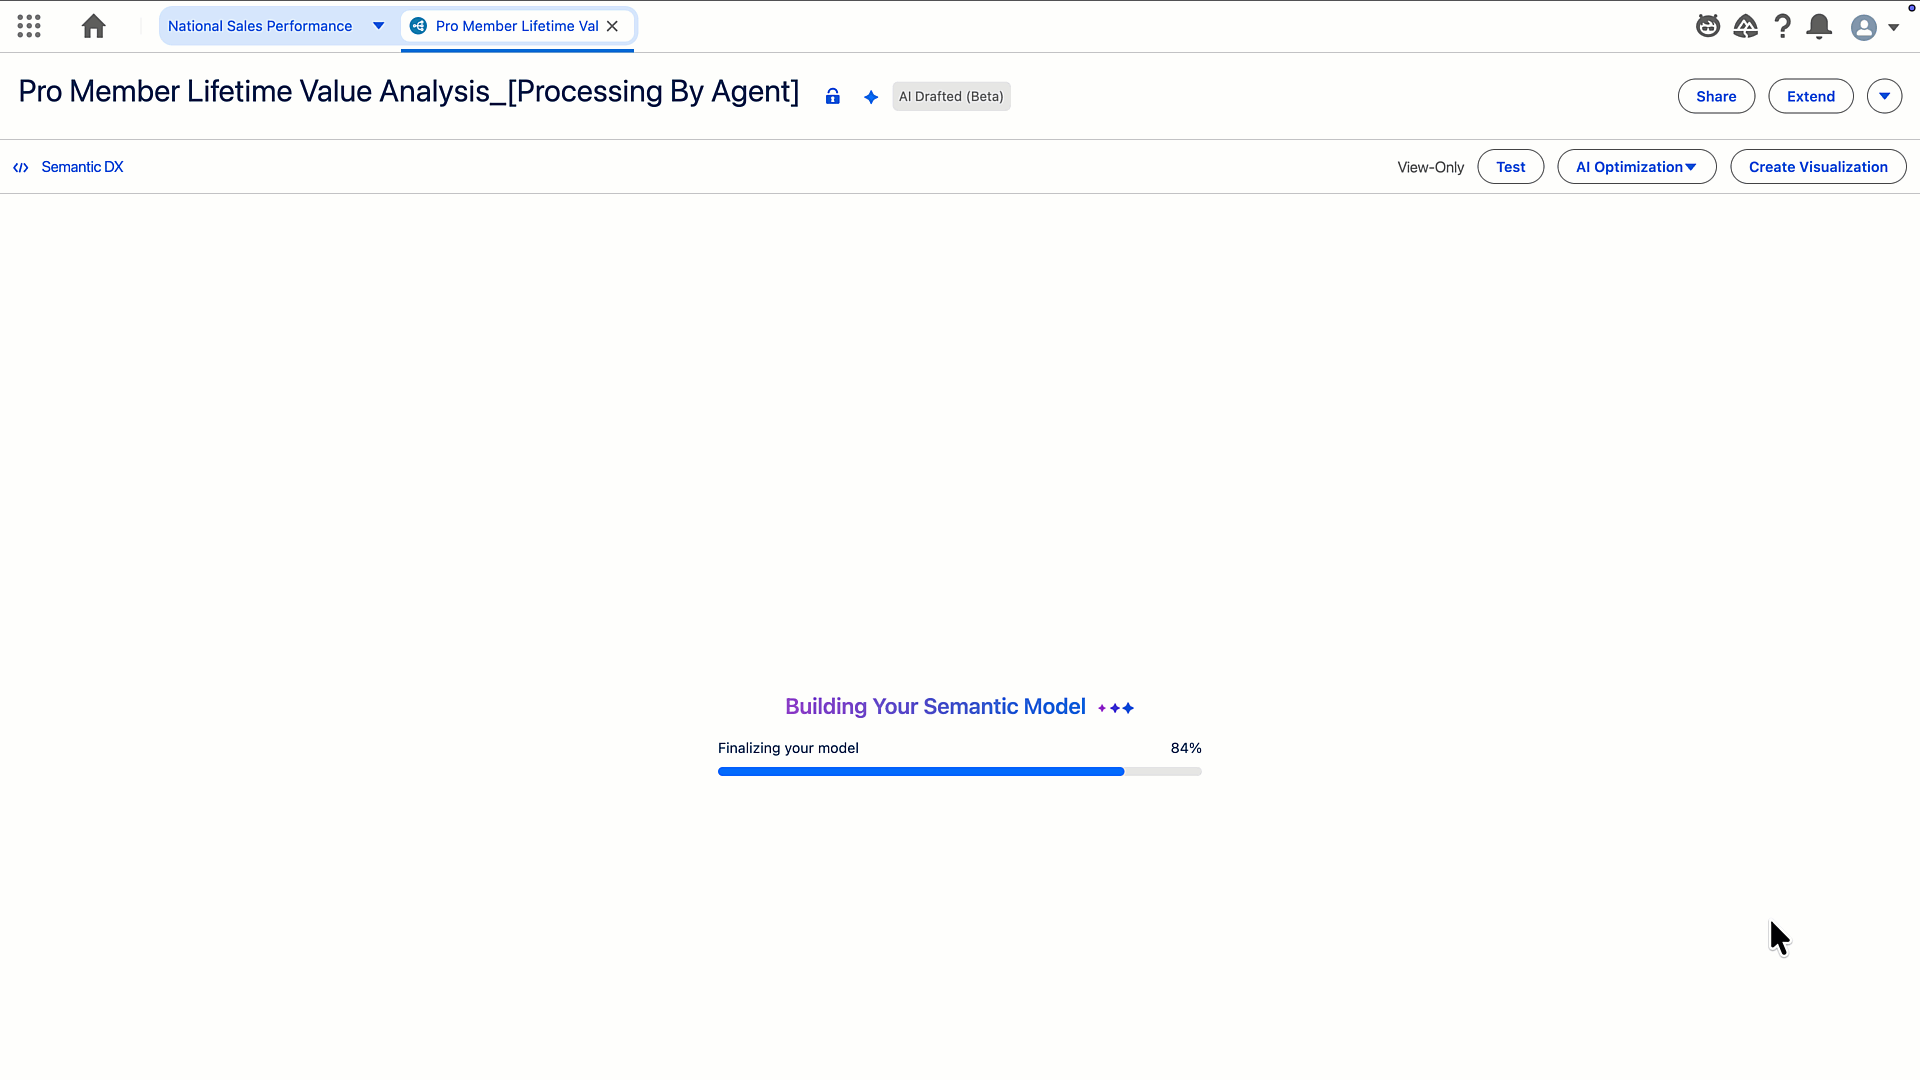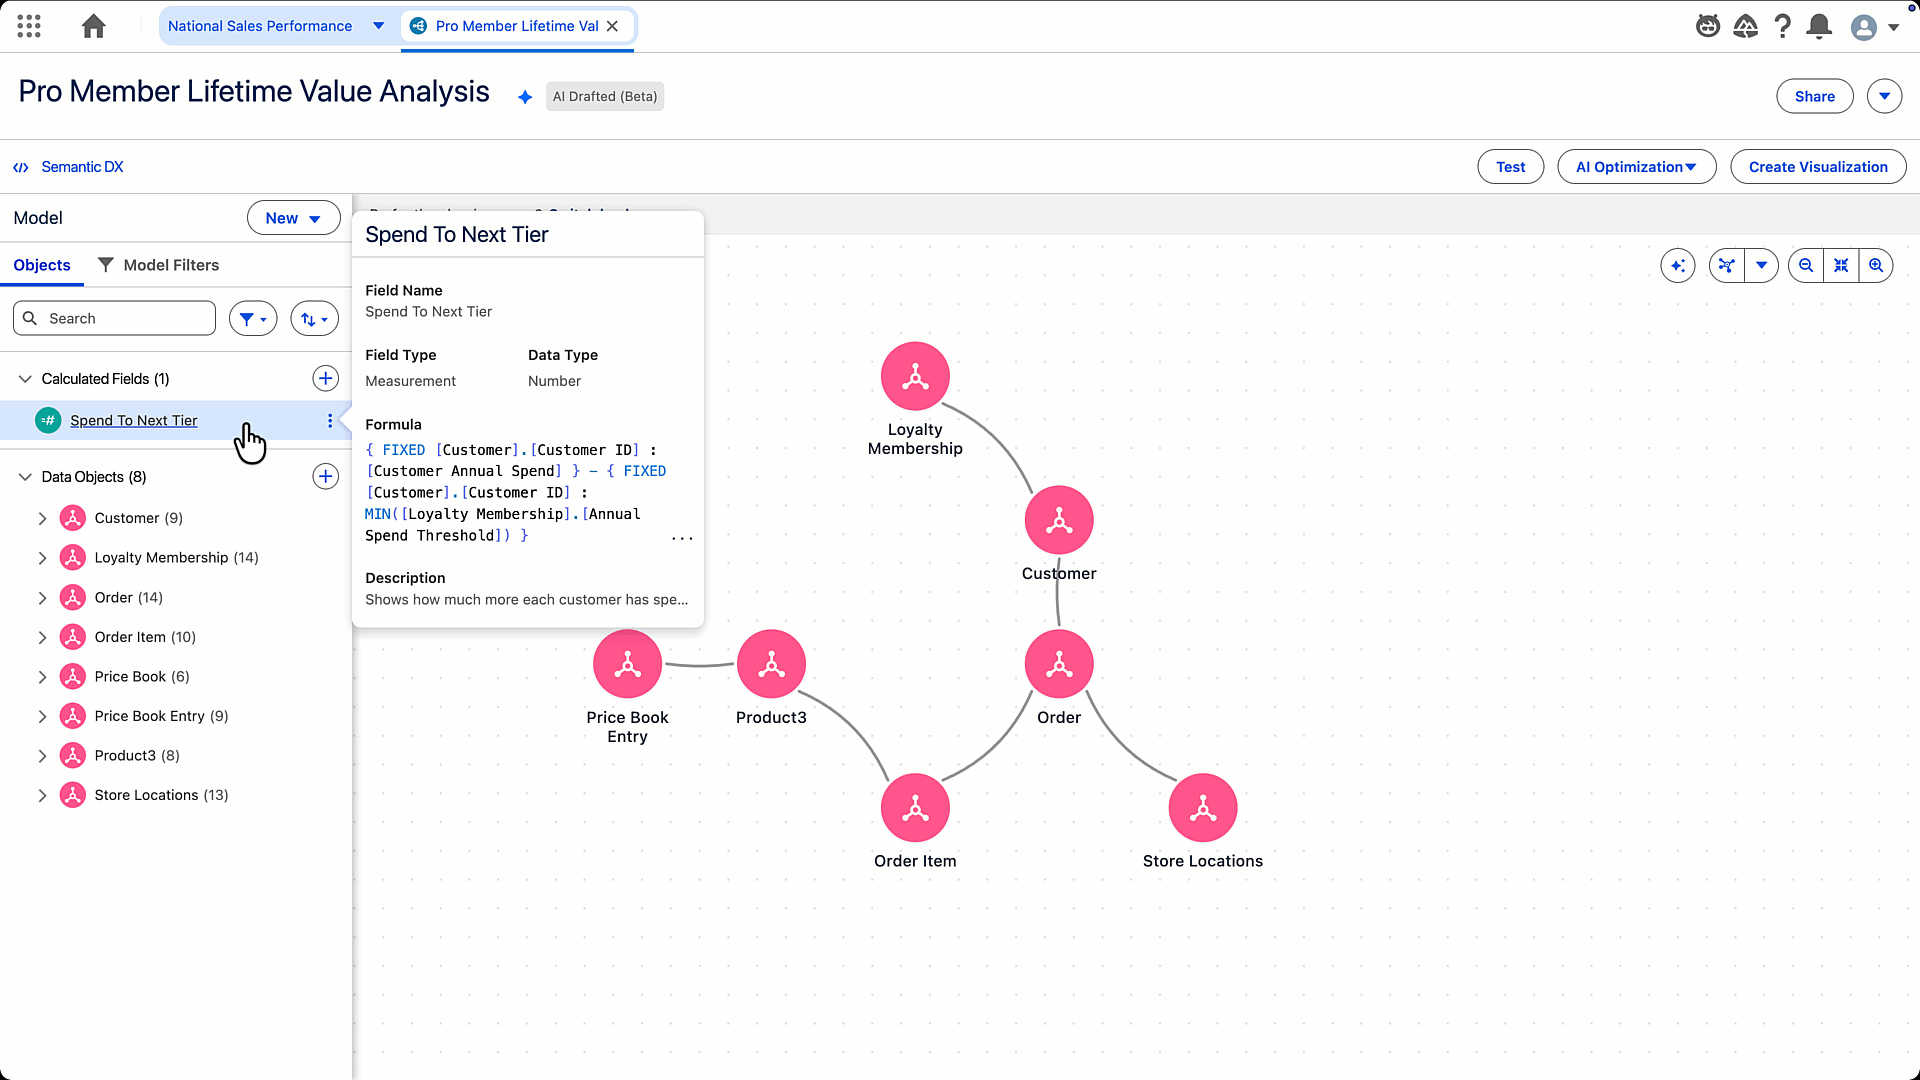
- Tableau Agent を使用して自然言語で生成する: 新規の分析の場合、ビジネス要件を平易な言葉で記述するだけで作成プロセスを加速できます。Tableau Agent はユーザーに代わって、関連するデータオブジェクトを自動的に識別し、結合と計算フィールドを設定し、基となる関係性をマッピングします。
- 既存のデータから生成する: CRM Analytics や Tableau Cloud で、すでに時間をかけて選び、整備・調整してきた信頼性の高いデータセットがあれば、数回クリックするだけでセマンティックモデルを自動生成できます。これにより、クリーニングと検証が済んだデータをチームが再びモデリングすることなく、エージェンティック分析を迅速に実現できます。
- 既存のセマンティックモデルを拡張する: コンポーザブルモデリングにより、チームは検証済みのモデルに新しいデータを追加して拡張したり、標準化された指標を複数の分析で再利用したりすることができます。これによって各部門のチームは、コアとなるガバナンスを維持しながら、ロジックにずれが生じるリスクを負うことなく規模を拡大できます。
4.実装とテストを反復して行う
ロジックを早期かつ頻繁に検証することで、微妙な計算ミスや結合によるファンアウトがエンドユーザーの結果に紛れ込むのを防ぐことができます。
- [モデルをテスト] 機能を使用する: モデルエディター内で頻繁にチェックを実行し、計算結果と行数を検証します。
- ビジュアライゼーションによって検証する: クエリの結果だけでは、全体像を把握することはできません。Tableau Next でテストビューを作成し、エンドユーザーがデータをフィルタリング、ドリルダウン、または集計した際にデータが期待どおりに動作することを確認します。結合のカーディナリティが不適切だと、行が重複して集計値が膨らむファンアウトが発生するため、注意が必要です。
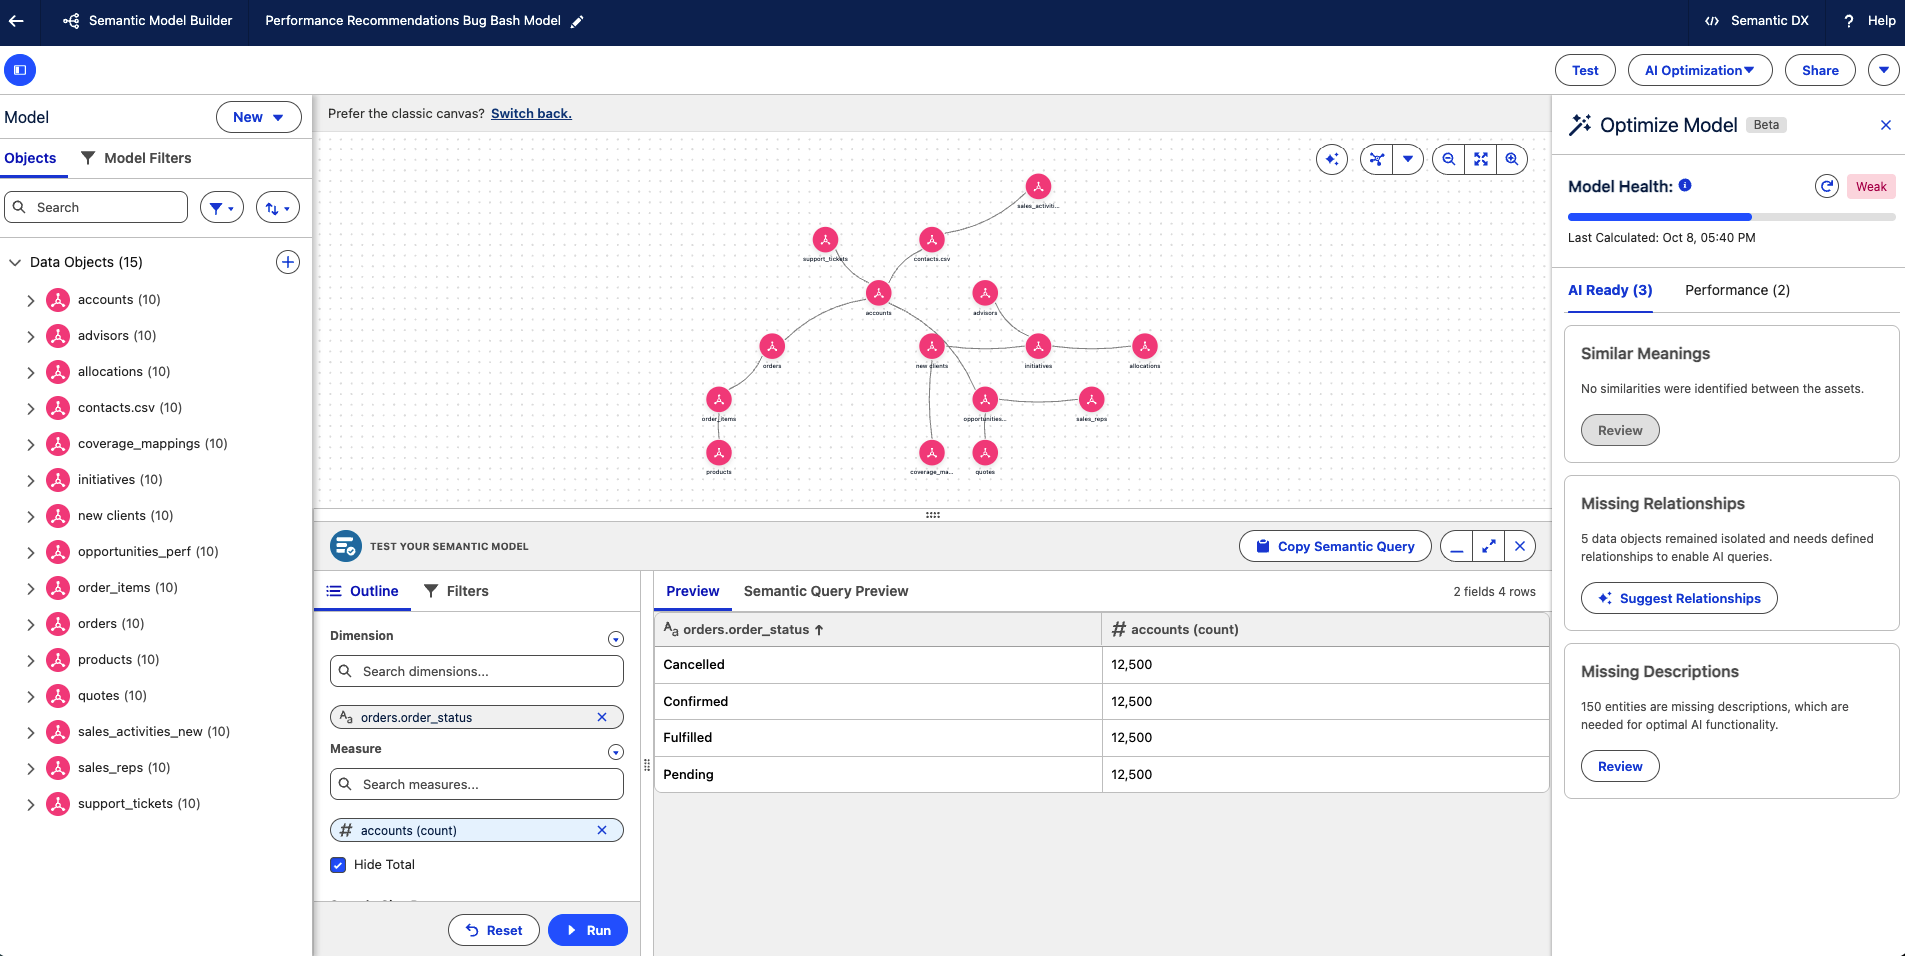
- モデルが AI 対応であることを確認する: モデルの状態をテストし、説明やデータ間の関係の不足を補って精度を高めるための推奨事項や、パフォーマンス改善のための推奨事項を確認します。AI で編集作業を自動化し、モデル全体に効率よく変更を適用します。
5.クエリパフォーマンスを最大限に高められるように設計する
エンタープライズ規模のデータセット、特に 1 億行を超えるデータセットを扱う場合、パフォーマンスは最重要事項となります。クエリのレイテンシーは、ユーザーの利用率と AI の応答性に直接影響を与えます。
- 結合処理を簡潔かつ効率的に行う: 実行時にリアルタイムで行う複雑な結合処理は、ダッシュボードの動作が遅くなる主な原因です。
- 実行時の結合を最小限に抑える: 一般的なクエリでは、結合回数を 6 ~ 7 回未満に抑えることを目標にします。
- 多対多の結合は避ける: クロス結合や、複雑で処理負荷の高い演算子 (BETWEEN など) は避けてください。大規模なデータセットに対してこれらを使うと、膨大な処理能力が必要になります。
- プライマリキーで結合する: 結果セットが爆発的に増えるのを防ぐために、結合パスにはプライマリキーまたは一意の識別子列を使用するようにします。
- 結合のカーディナリティを定義する: エディターで常に正しいリレーションシップカーディナリティ (1 対 1、1 対多、または多対 1) を設定します。カーディナリティを明示すれば、エンジンが安全側に立った仮定を置くことで、不要な DISTINCT クエリが生成されたり、メジャーのファンアウトが発生したりするのを防げます。
- 結合フィールド間で文字列の大文字と小文字を一致させる: Tableau Semantics はデフォルトで、クエリ速度を最大化するために大文字と小文字を区別する結合を実行します。ソースデータに文字列の大文字と小文字の不一致 (例: 「ID_abc」と「ID_ABC」) がある場合は、コードでカスタム文字列関数を作成するのではなく、テーブルリレーションシップ UI を使用して結合プロパティを調整します。
- 非常に大規模なデータセット (1 億行以上) 向けに最適化する:
- パーティション分割を活用する: デフォルトのダッシュボードフィルターが、Data 360 における基盤となるデータレイクオブジェクト (DLO) のパーティション分割方法と一致していることを確認します。
- セカンダリインデックスを検討する: 特定のフィルタリングパターンが頻繁に使用されている場合は、 セカンダリインデックスを活用します。
- 変換処理を前段階で行う (ETL): 負荷の高い計算や変換処理をクエリの実行時ではなく事前に行える場合は、前段階で処理を済ませておきます。Data 360 のネイティブ変換機能 (バッチデータ変換、計算済みインサイト) を活用して、複雑な計算を事前に実行したり、大量のデータを集計したりできます。これにより、変換処理やインサイトの更新頻度に応じて、実行時のレイテンシーを削減し、計算コストを低減できる可能性があります。
6.セキュリティとガバナンスを一元管理する
セマンティックモデルはデータへのアクセスを容易にするべきですが、セキュリティを犠牲にしてはなりません。
- Data 360 でセキュリティを適用する: 行レベルのセキュリティ (RLS) とアクセス制御は、常に Data 360 のネイティブポリシーを使用して管理します。
- フィルターベースのセキュリティを避ける: データセキュリティを確保するために、標準的なセマンティックモデルフィルターに頼ることはしないでください。モデルのフィルターは、データを保護するためではなく、業務に必要なデータを絞り込むためのものです (例: 非アクティブな取引先を除外する)。カスタムのアドホッククエリによって回避される可能性もあります。
7.標準化して拡張する
規模の拡大を見据えて構築するには、モデルを孤立したデータサイロにせず、全社的な標準に合わせることが重要です。
- 業務部門の担当者とレビューする: パブリッシュする前に、ビジネスオーナーと話し合い、重要な検証事項について確認します。このエンティティは必要なレポーティングシナリオをすべて網羅しているか? 重複している項目や指標はあるか?
- 標準的なエンタープライズモデルを再利用する: 可能な限り、カスタムスキーマをゼロから構築するのではなく、既存の確立された標準モデル (Salesforce Customer 360 など) を拡張します。これにより、部門間のレポーティングの一貫性が保証されます。
- モデルの作成を加速する: Tableau Semantics には、自動レイアウト、範囲の制限なく移動できるナビゲーション、インライン編集、ドメイン別のグループ化など、ドラッグ & ドロップで直感的に操作できるキャンバス機能があります。これらを使えば、規模の拡大に対応できるワークスペースで、複雑な企業のスキーマを探索、更新、構造化できます。
8.本番環境の負荷でストレステストを実施する
1 万行のデータを含むサンドボックス環境では問題なく動作するデータモデルでも、数百万件の本番環境のレコードを処理しようとするとまったく異なる挙動を示す場合があります。
- 本番環境の実際の規模をシミュレートする: 本番環境の実際のデータ量に対してクエリをテストすることで、ユーザーに問題が発生する前にボトルネックを特定できます。
- ユーザーの実際のクエリパターンでストレステストを実施する: 業務のピーク時にパワーユーザーや自動化ワークフローが実行する処理を想定し、多数の同時実行による負荷や、複数のフィルターを複雑に組み合わせた選択をシミュレートします。
もっと詳しく知るには
- セマンティクを AI で活用できる状態にする方法を、Dreamforce のオンデマンドセッションでご覧ください。
- Tableau Semantics モジュールを活用して、Trailhead でスキルアップしましょう。
関連ストーリー
Tableau Data Apps: From Prompt to Trusted Agentic Analytics
 2026/11/03

Turn Autonomous Insights into Action: How to Set Up Proactive Intelligence with Tableau Next
 2026/11/02
Tableau が Salesforce 社内でエージェンティック分析を構築した方法: 4 つの要素からなるフレームワーク
 2026/10/12